


Công khai dữ liệu văn bản, hình ảnh và bộ dữ liệu ký tự từ thư viện chia sẻ
Hơn 38 triệu dữ liệu từ sách, bảng biểu, hình minh họa, quảng cáo, ảnh và nhiều tài liệu khác sẽ được công bố cho toàn dân.
Thư viện Quốc gia Trung ương đã thông báo vào ngày 17 rằng họ sẽ lần đầu tiên công khai dữ liệu học máy (AI) từ tài liệu quốc gia cho công chúng.
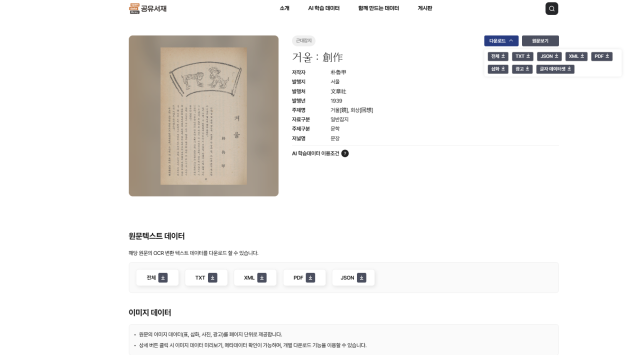
Các dữ liệu được công bố bao gồm 3.974 cuốn sách dữ liệu văn bản (Hidden Text PDF, XML, TXT, JSON), 21.485 dữ liệu hình ảnh từ bảng biểu, hình minh họa, quảng cáo và ảnh, cùng với 38 triệu bộ dữ liệu ký tự và tổng cộng lên tới 38.33 triệu dữ liệu.
Cùng với việc công khai dữ liệu này, nền tảng dự án trước đây mang tên ‘Thư viện chia sẻ’ đã được cải tiến để tối ưu hóa cho việc sử dụng dữ liệu học máy AI. Việc cải tiến này tập trung vào việc tăng cường tính tiện lợi để mọi người có thể dễ dàng sử dụng cho nhiều mục đích khác nhau như học máy, nghiên cứu học thuật, phát triển dịch vụ và ứng dụng, cũng như sản xuất nội dung.
Dữ liệu được công khai là các tài liệu số hóa từ Thư viện Quốc gia Trung ương, bao gồm các tạp chí hiện đại từ những năm 1930-1940, tài liệu chính phủ và giáo trình từ những năm 1940-1960, cùng với các tài liệu do Thư viện Quốc gia Trung ương phát hành và các tài liệu học thuật mở (Open Access, OA) đã được cấp phép cho việc sử dụng học máy AI. Mọi người có thể tự do truy cập và tải xuống từ ‘Thư viện chia sẻ’.
Dữ liệu văn bản được cung cấp dưới dạng chất lượng cao đã được tinh chỉnh để AI dễ dàng nhận diện, có thể được sử dụng ngay lập tức cho nghiên cứu và phát triển dịch vụ. Đối với bộ dữ liệu ký tự, các dữ liệu ký tự đa dạng có thể được sử dụng ngay cho việc học máy AI, giúp các doanh nghiệp vừa và nhỏ gặp khó khăn trong việc thu thập dữ liệu lớn có thể rộng rãi sử dụng cho việc phát triển công nghệ nhận diện ký tự (OCR) và xử lý ngôn ngữ tự nhiên.
‘Thư viện chia sẻ’ đã được cải tiến cũng tăng cường các chức năng hỗ trợ nghiên cứu AI và nhân văn số, mở rộng việc sử dụng dữ liệu công cộng. Bằng cách tổ chức và xử lý khối lượng kiến thức khổng lồ đã được số hóa để AI có thể học, nghiên cứu nhân văn dựa trên dữ liệu lớn mà trước đây khó khăn sẽ trở nên khả thi. Các nhà nghiên cứu có thể dễ dàng thực hiện nghiên cứu nhân văn số bằng cách phân tích tài liệu, hồ sơ và hình ảnh bằng AI để rút ra những ý nghĩa mới.
Hơn nữa, việc công khai quy mô lớn các tài liệu quốc gia đã được giải quyết vấn đề bản quyền để có thể sử dụng ngay cho việc học máy AI cũng mang ý nghĩa quan trọng. Điều này được kỳ vọng sẽ giảm bớt gánh nặng cho các nhà nghiên cứu và doanh nghiệp vừa và nhỏ, những người đã gặp khó khăn trong việc thu thập dữ liệu học máy do chi phí và vấn đề bản quyền.
Môi trường người dùng của nền tảng cũng đã được cải thiện để thân thiện hơn với người sử dụng. Cấu trúc giao diện trực quan và cấu trúc tìm kiếm theo loại tài liệu và loại hình ảnh đã được áp dụng, cho phép mọi người dễ dàng truy cập dữ liệu mà không cần thủ tục đăng ký riêng, giúp cả nhà nghiên cứu chuyên nghiệp và người dùng thông thường đều có thể dễ dàng tìm kiếm và sử dụng tài liệu.
Thư viện Quốc gia Trung ương dự kiến sẽ tiếp tục mở rộng việc xây dựng và công khai dữ liệu, đồng thời nâng cao dịch vụ sử dụng AI, với kế hoạch phát triển ‘Thư viện chia sẻ’ thành một nền tảng dữ liệu có khả năng phát triển bền vững. Vào cuối năm nay, thư viện sẽ công khai thêm dữ liệu văn bản từ khoảng 300 cuốn tiểu thuyết bản chữ Hàn.
Bà Lee Hyun-joo, trưởng phòng Kế hoạch Thông tin số của Thư viện Quốc gia Trung ương, cho biết: “Chúng tôi sẽ tiếp tục mở rộng phạm vi công khai dữ liệu, để mọi người dân đều có thể hưởng lợi từ tài nguyên tri thức công cộng trong thời đại AI.”
* Bài viết này được dịch tự động bằng AI.

Yoon Juhye
jujusun@ajunews.com
© Bản quyền thuộc về Thời báo Kinh tế AJU & www.ajunews.com: Việc sử dụng các nội dung đăng tải trên vietnam. kyungjeilbo.com phải có sự đồng ý bằng văn bản của Aju News Corporation.