


Trí tuệ nhân tạo (AI) đang tiến hóa từ chatbot sang giai đoạn suy luận và tác nhân, dẫn đến việc nút thắt trong hệ thống AI chuyển từ thiết bị tính toán sang bộ nhớ. SK Hynix đã xác định rằng các vấn đề về hiệu suất, hiệu quả năng lượng và sử dụng tài nguyên đều tập trung vào bộ nhớ, trở thành thách thức chính của hệ thống AI. Họ cho rằng, việc giảm khoảng cách giữa bộ nhớ và thiết bị tính toán, cùng với việc nhiều bộ tăng tốc chia sẻ bộ nhớ, sẽ là lĩnh vực cạnh tranh tiếp theo trong sự mở rộng của AI.
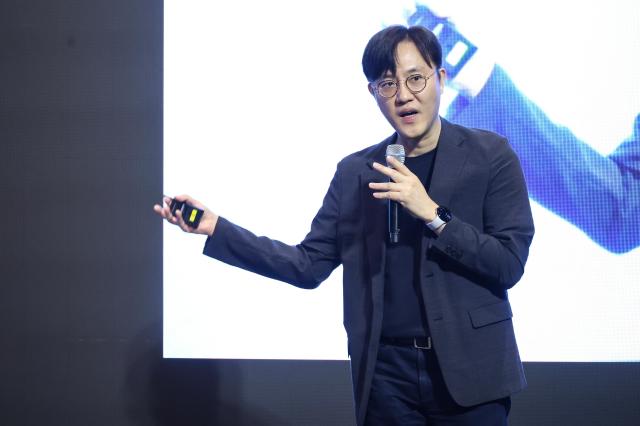
Phó chủ tịch Chu Young-pyo của SK Hynix đã phát biểu tại Diễn đàn toàn cầu về tăng trưởng tốt và việc làm tốt lần thứ 18 (2026 GGGF) rằng: "Gần đây, dường như bộ nhớ đang trở thành vấn đề chính" và "Các vấn đề tối ưu hóa hiệu suất, hiệu quả năng lượng và hiệu quả tài nguyên đều nằm trước bộ nhớ". Ông nhấn mạnh rằng "nơi có nút thắt chính là trung tâm của tính toán" và "hiện tại, nút thắt là bộ nhớ".
Sự thay đổi trong dịch vụ AI đang thúc đẩy nhu cầu về bộ nhớ. Các chatbot trước đây chỉ cần điều chỉnh tốc độ giao tiếp với người dùng, nhưng AI tác nhân cần giao tiếp giữa các AI, tạo mã và thực hiện, sau đó sửa lỗi và tiếp tục công việc. Ông cho biết: "Khi giao tiếp với con người, chỉ cần khoảng 20 token mỗi giây, nhưng khi máy móc giao tiếp với nhau, cần phải trả lời với tốc độ hàng nghìn token mỗi giây", cho thấy yêu cầu về hiệu suất hệ thống đang gia tăng đáng kể.
SK Hynix đã xác định hướng đi đổi mới bộ nhớ của mình dựa trên ba trụ cột: hiệu suất, hiệu quả năng lượng và mức độ sử dụng tài nguyên. Việc nâng cao băng thông bộ nhớ trong một diện tích nhất định và giảm năng lượng cần thiết để truyền một bit dữ liệu đến các thiết bị tính toán như GPU, NPU, TPU là rất quan trọng. Họ cũng nhấn mạnh việc nâng cao mức độ sử dụng hệ thống để các GPU và bộ nhớ đắt tiền hoạt động liên tục.
HBM là một ví dụ điển hình cho sự thay đổi này. Ông cho biết: "Có thể nói rằng HBM đã được chú ý nhờ GPU, nhưng chính nhờ có bộ nhớ như HBM mà GPU mới có thể đạt được hiệu suất tốt hơn". Ông cũng giải thích rằng trong thời đại AI tác nhân, ngành công nghiệp đang lo lắng về việc liệu sự kết hợp hiện tại giữa HBM và GPU có đủ hay không.
Một trong những giải pháp là giảm khoảng cách giữa bộ nhớ và thiết bị tính toán. Việc xếp chồng DRAM theo chiều dọc trên hoặc dưới bộ xử lý có thể rút ngắn khoảng cách di chuyển dữ liệu. PIM, nơi thực hiện tính toán ngay trong hoặc gần bộ nhớ, cũng nằm trong cùng một bối cảnh. Ông nhấn mạnh rằng: "Việc lấy dữ liệu từ bộ nhớ và đưa đến thiết bị tính toán tiêu tốn nhiều năng lượng hơn so với việc thực hiện một phép toán" và "khi khoảng cách di chuyển càng xa, hiệu quả năng lượng sẽ giảm nhanh chóng". Tuy nhiên, ông cũng lưu ý rằng việc xếp chồng 3D vẫn còn gặp phải những thách thức kỹ thuật như nhiệt độ và giảm không gian lưu trữ.
CXL, nơi nhiều bộ tăng tốc chia sẻ bộ nhớ, cũng được đề xuất như một giải pháp. Trước đây, GPU phải chờ đợi cho đến khi GPU khác sẵn sàng nhận công việc, nhưng với bộ nhớ chia sẻ, dữ liệu có thể được gửi trước và lấy lại khi thiết bị tính toán tiếp theo cần. SK Hynix đang nghiên cứu cách giảm lãng phí trong quá trình sao chép và đồng bộ hóa dữ liệu giữa các GPU thông qua CXL. Ông cho biết CXL không phải là tiêu chuẩn được phát triển đặc biệt cho AI, nhưng nhờ tính chất của giao diện bộ nhớ mở, việc áp dụng cho hệ thống AI đang ngày càng mở rộng.
Ông đã bác bỏ quan điểm cho rằng việc tối ưu hóa thuật toán AI sẽ dẫn đến giảm nhu cầu về bộ nhớ. Ông lấy ví dụ về "nghịch lý Jevons", trong đó mặc dù hiệu suất nhiên liệu ô tô đã được cải thiện, nhưng tổng tiêu thụ dầu mỏ lại tăng lên, và cho biết: "Khi chi phí dịch vụ AI giảm, người ta sẽ sử dụng dịch vụ AI nhiều hơn". Điều này có nghĩa là mặc dù việc tối ưu hóa thuật toán có thể giảm mức sử dụng bộ nhớ của từng dịch vụ, nhưng nếu tổng nhu cầu AI tăng lên, nhu cầu về bộ nhớ cũng sẽ tăng theo.
Ông nhấn mạnh rằng: "Trong quá khứ, CPU là nút thắt của hệ thống, và khi cải thiện CPU, hiệu suất hệ thống sẽ tăng lên" và "hiện tại, nút thắt là bộ nhớ". Ông kết luận rằng: "Nếu nâng cao hiệu suất và hiệu quả năng lượng của bộ nhớ, hệ thống AI sẽ trở nên tốt hơn rất nhiều".
* Bài viết này được dịch tự động bằng AI.

© Bản quyền thuộc về Thời báo Kinh tế AJU & www.ajunews.com: Việc sử dụng các nội dung đăng tải trên vietnam. kyungjeilbo.com phải có sự đồng ý bằng văn bản của Aju News Corporation.