


Mở rộng hiệu suất suy diễn của Vera Rubin NVL72... tạo ra 3.400 token mỗi giây
Các công ty AI Cloud như Nebius bắt đầu áp dụng... cuộc cạnh tranh hạ tầng suy diễn chính thức bắt đầu
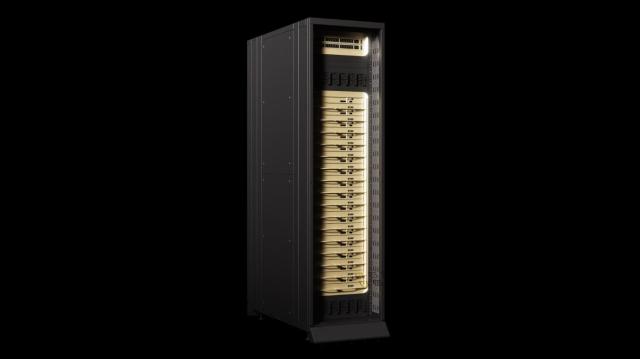
NVIDIA đã bắt đầu sản xuất hàng loạt bộ tăng tốc suy diễn 'Grok 3 LPX' nhằm nâng cao tốc độ phản hồi của các tác nhân AI. Cuộc cạnh tranh hạ tầng nhằm tăng tốc độ tạo token, một yếu tố cốt lõi của AI tương tác, đang trở nên sôi động hơn trong bối cảnh cạnh tranh hiệu suất tính toán AI xử lý dữ liệu lớn.
Vào ngày 25 tháng 8, tại sự kiện Hot Chips diễn ra ở Santa Clara, California, NVIDIA đã công bố việc sản xuất hàng loạt Grok 3 LPX. Grok 3 LPX là bộ tăng tốc suy diễn AI tương tác mở rộng từ nền tảng Vera Rubin thế hệ tiếp theo của NVIDIA.
Các tác nhân AI thực hiện nhiều bước suy diễn và gọi công cụ để thực hiện các nhiệm vụ phức tạp. Số lượng token được tạo ra trong quá trình này càng nhiều, tốc độ tạo ra từng token càng nhanh sẽ ảnh hưởng đến tổng thời gian thực hiện nhiệm vụ. NVIDIA cho biết Grok 3 LPX đã tập trung vào điểm này.
NVIDIA cũng đã công bố hiệu suất của Grok 3 LPX. Theo thông tin từ NVIDIA, Grok 3 LPX đã ghi nhận 3.400 token đầu ra mỗi giây trong bài kiểm tra phân tích nhân tạo với mô hình tương tác mã nguồn mở Gemma 4 31B. Đây là tốc độ tối đa của mô hình này khi áp dụng ngữ cảnh 100.000 token.
NVIDIA cho biết Grok 3 LPX cung cấp tốc độ phản hồi nhanh hơn gấp 4 lần so với các nền tảng tương tự trong các tác vụ nhạy cảm với độ trễ như lập trình tương tác. Mục tiêu là giảm thời gian thực hiện của các tác nhân AI, từ việc viết mã và kiểm tra đến xem xét tệp và xác minh kết quả.
Grok 3 LPX sẽ bổ sung hiệu suất suy diễn cho hệ thống Vera Rubin NVL72. Vera Rubin là nền tảng hỗ trợ cả việc học và suy diễn cho các mô hình AI quy mô lớn. Việc kết hợp Grok 3 LPX, chuyên về tốc độ tạo token, nhằm đáp ứng đồng thời hai yêu cầu của AI tương tác là xử lý ngữ cảnh quy mô lớn và phản hồi thời gian thực.
Các công ty AI Cloud cũng đang bắt đầu áp dụng. Nebius có kế hoạch tích hợp Grok 3 LPX vào nền tảng suy diễn sản xuất của mình, 'Nebius Token Factory'. Mục tiêu là giúp các nhà phát triển có thể tận dụng tính năng tạo token siêu tốc trong khi vẫn duy trì API hiện tại. Công ty suy diễn AI Grok cũng sẽ là một trong những đơn vị đầu tiên áp dụng.
Việc sản xuất hàng loạt lần này cũng có ý nghĩa trong việc thay đổi tiêu chuẩn cạnh tranh hạ tầng AI. Khi AI tạo sinh không chỉ dừng lại ở việc trả lời câu hỏi mà còn tự lập kế hoạch và thực hiện nhiều nhiệm vụ, tốc độ tạo token và thời gian phản hồi đã trở thành những chỉ số hiệu suất quan trọng bên cạnh khả năng xử lý tính toán đơn giản.
NVIDIA đang xây dựng một hệ thống theo dạng rack kết hợp CPU, DPU, lưu trữ và Ethernet cho nền tảng Vera Rubin. Họ đang tối ưu hóa toàn bộ nền tảng, bao gồm cả Grok 3 LPX, cho khối lượng công việc của các tác nhân AI, nhằm duy trì vị thế dẫn đầu trong thị trường hạ tầng suy diễn của trung tâm dữ liệu AI.
* Bài viết này được dịch tự động bằng AI.

SEONGJUN JO
critic@ajunews.com
© Bản quyền thuộc về Thời báo Kinh tế AJU & www.ajunews.com: Việc sử dụng các nội dung đăng tải trên vietnam. kyungjeilbo.com phải có sự đồng ý bằng văn bản của Aju News Corporation.